Créer une connexion
Les connexions stockent de manière sécurisée les accès à vos sources et destinations (bases de données, stockage de fichiers, APIs, canaux de notification).
Le principe clé du modèle projet-centric :
- une connexion est définie au niveau du projet : son identité (le nom
pg-main, son type PostgreSQL) et ses paramètres ; - ses valeurs (hôte, identifiants, mot de passe…) sont propres à chaque
environnement :
devetprodne pointent pas sur la même base.
Voir Environnements et déploiement pour le modèle complet.
Créer une connexion (Studio)
Les connexions s'éditent dans une copie de travail (Studio), car un projet société est en lecture seule.
- Ouvrez votre copie de travail, onglet Connexions ;
- cliquez sur Nouvelle connexion : un assistant en quatre étapes s'ouvre (Type, Identité, Configuration, Test & récap) ;
- choisissez la catégorie puis le type (voir
Types de connexions) :
- Bases de données : PostgreSQL, MySQL, SQL Server, Oracle, SQLite, Snowflake, BigQuery, Redshift, Databricks SQL ;
- Fichiers & stockage : disque local, Amazon S3, Google Cloud Storage, Azure Blob, SFTP / FTP ;
- APIs : REST ;
- Notifications : SMTP / Email, Slack, Microsoft Teams, Discord, Webhook générique, PagerDuty ;
- donnez un nom parlant (
pg-main,s3-datalake…), renseignez les paramètres, testez, puis créez.
 L'assistant de création : type, identité, configuration, test.
Vous pouvez aussi créer une connexion à la volée depuis l'onglet Connexion du panneau de réglages d'une brick.
Exemple : PostgreSQL
| Champ | Description | Exemple |
|---|---|---|
| Nom | Nom de la connexion | pg-main |
| Hôte | Adresse du serveur | db.example.com |
| Port | Port de connexion | 5432 |
| Base de données | Nom de la base | production |
| Utilisateur | Nom d'utilisateur | app_user |
| Mot de passe | Secret (chiffré) | **** |
| Mode SSL | Chiffrement du transport | require |
Tester une connexion
Le test s'exécute via votre runner (il doit être en ligne) : c'est lui qui tente réellement de se connecter, avec les valeurs courantes. Le résultat s'affiche dans l'assistant, et reste disponible ensuite depuis la carte de la connexion (onglet Connexions du projet).
Renseigner les valeurs par environnement
Créer la connexion dans le projet la fait apparaître dans chaque environnement, où l'on règle ses valeurs :
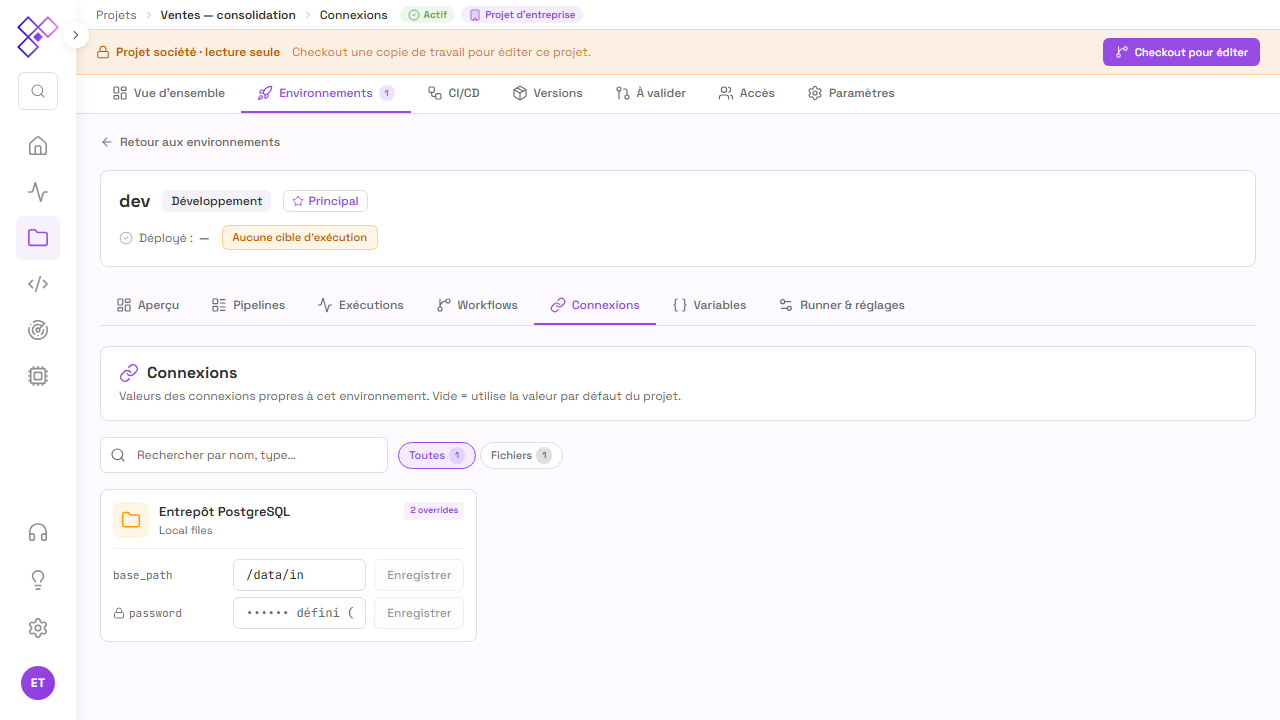 Onglet Connexions d'un environnement : pour chaque paramètre, la valeur de
l'environnement et, en repli, la valeur par défaut du projet.
- Ouvrez l'onglet Environnements du projet, puis un environnement ;
- sous-onglet Connexions : chaque carte liste les paramètres de la connexion ;
- renseignez les valeurs propres à cet environnement ; une valeur vide utilise la valeur par défaut du projet.
À l'exécution sur un environnement, le runner reçoit les valeurs de cet environnement.
Utiliser une connexion dans un pipeline
- Ajoutez une brick (ex. Source base de données) ;
- dans son onglet Connexion, sélectionnez la connexion du projet ;
- à l'exécution, les valeurs résolues (selon l'environnement, ou les valeurs du projet en Studio) sont transmises au runner.
Voir Configurer les bricks.
L'éditeur SQL : lire, et écrire
Le visualiseur de données d'une connexion ouvre un éditeur SQL. Il a deux modes, et le bouton en haut de la barre les bascule.
Lecture — le défaut
Seuls SELECT et WITH partent. Le serveur refuse tout le reste, et le runner
exécute dans une transaction qu'il annule : ce que la requête aurait pu
écrire ne survit pas à l'aperçu, qu'on ait su le nommer ou non.
Le résultat est borné au nombre de lignes choisi dans la barre.
Écriture
L'énoncé part tel quel — pas de borne, ce n'est plus un aperçu — et son
effet est conservé. UPDATE, INSERT, DELETE, CREATE TABLE,
ALTER TABLE (y compris pour changer la longueur d'un champ), DROP : tout le
travail de données ordinaire.
| Lecture | Écriture | |
|---|---|---|
| Ce qui part | SELECT, WITH | tout le travail de données |
| L'effet | annulé | conservé |
| Le résultat | des lignes, bornées | un compte de lignes affectées |
| Le droit | aucun de plus | connection:write_sql |
| La trace | aucune | audit : l'énoncé, qui, quand |
Le droit connection:write_sql, accordé par défaut aux seuls
administrateurs — développer un flux et modifier à la main la base d'un
client sont deux métiers. Une équipe qui veut l'ouvrir à ses ingénieurs le fait
depuis l'écran des rôles.
Le mode repart de Lecture à chaque ouverture : il n'est jamais mémorisé. Un interrupteur qu'on retrouve armé est un interrupteur qu'on oublie.
Chaque écriture est confirmée — l'énoncé est redit tel qu'il partira — et consignée à l'audit avant son exécution : tracer après coup ne garderait que ce qui a abouti, et c'est justement l'énoncé qui a mal tourné qu'on cherchera.
Deux règles, même en écriture
Un seul énoncé à la fois. Le point-virgule est l'outil de l'accident comme
de l'attaque : UPDATE t SET a=1; DROP TABLE t part en une frappe. Créez la
table, puis remplissez-la : deux gestes, deux confirmations.
Rien qui ne soit du travail de données. Arrêter le serveur, tuer une session, sauvegarder, distribuer des droits, lire un fichier de la machine hôte : leur portée dépasse la base, et ce n'est pas ce qu'on vient faire dans un éditeur de requêtes.
Ces règles réduisent les accidents. Elles n'arrêtent pas quelqu'un de
décidé : le SQL dynamique (EXEC('…')) échappe par construction à toute
analyse du texte, puisque ce qu'il exécute n'existe pas encore au moment où on
le lit.
Une connexion dont le compte n'a pas le droit de supprimer ne supprimera pas, quoi qu'on tape. C'est là que se règle le risque — d'où les comptes de service dédiés, aux permissions minimales, recommandés ci-dessous.
Modifier la structure d'une table, sans écrire de SQL
Allonger un varchar(20) devenu trop court est un geste d'exploitation
ordinaire — et il obligeait pourtant à rouvrir l'éditeur SQL, retrouver le nom
exact du schéma, et réécrire à la main un ALTER TABLE dont la syntaxe change
avec le moteur. La table était là, sous les yeux, et on tapait son nom ailleurs.
Dans l'arbre des connexions, survolez une table : à côté de l'œil (qui montre les lignes), une seconde icône montre les colonnes et leurs types.
| Ce qui s'édite | Ce qui ne s'édite pas ici |
|---|---|
Le type (varchar, numeric, date…) | Renommer une colonne |
| Sa taille — longueur, ou précision et échelle | Clés, index, contraintes |
L'acceptation du vide (NULL / NOT NULL) | |
| Ajouter une colonne, avec sa valeur par défaut | |
| Supprimer une colonne |
Renommer reste dehors : cela casse tout ce qui cite la colonne par son nom, et une clé engage des index et des contraintes — deux gestes qui demandent de savoir ce qu'il y a autour, pas seulement ce qu'il y a dans la table.
Le type se choisit dans une liste déroulante, celle du moteur. « Autre… » bascule en saisie libre : une liste fermée ferait de cet écran un mur dès qu'un type sort de l'ordinaire, et ils en sortent souvent.
Supprimer : ça se marque, ça ne s'exécute pas
La ligne reste visible, barrée, et le geste se défait d'un clic tant qu'on n'a pas appliqué. Sur une colonne dont le contenu part pour de bon, donner l'impression que c'est déjà fait serait la pire des impressions.
Ajouter : pensez à la valeur par défaut
Une colonne obligatoire ajoutée à une table qui porte déjà des lignes échoue : il n'y a rien à mettre dans les anciennes. L'écran le signale avant d'envoyer quoi que ce soit. Une colonne neuve s'ouvre donc facultative — le réglage qui ne peut pas échouer.
L'ordre des trois temps
Corriger, puis ajouter, puis supprimer en dernier. La suppression est le seul geste irréversible de cet écran : la mettre à la fin garantit qu'un échec survenu avant — un retypage qui bute sur une valeur, un ajout obligatoire sur une table pleine — n'aura pas coûté une colonne pour rien.
Le SQL est montré avant de partir
Les énoncés générés s'affichent en bas du panneau, tels qu'ils partiront, et la confirmation les redit. Un écran qui modifie la base d'un client sans montrer ce qu'il exécute demande une confiance qu'il n'a pas gagnée.
Ils partent un par un — c'est la règle du mode écriture, et elle sert ici : chacun est consigné séparément dans l'audit, et si l'un échoue, l'écran dit lequel et relit la structure réelle plutôt que d'afficher ce qu'on visait.
Ce qui est annoncé avant
| Avertissement | Pourquoi |
|---|---|
Rétrécissement (varchar(50) → varchar(20)) | Les valeurs plus longues font échouer l'énoncé, ou sont tronquées |
Changement de famille (varchar → integer) | Les valeurs qui ne se convertissent pas font échouer l'énoncé |
| Interdiction du vide | Poser NOT NULL échoue si la colonne contient déjà des vides |
| Défaut redit (MySQL) | MODIFY COLUMN efface le défaut s'il n'est pas réécrit ; il l'est, et c'est à relire |
| Ajout obligatoire sans défaut | échoue si la table porte déjà des lignes |
| Suppression | la colonne et tout son contenu partent ; aucun ALTER ne les ramène |
Les énoncés ne se ressemblent pas d'un moteur à l'autre, et ce n'est pas cosmétique :
- PostgreSQL et Snowflake séparent le type et l'acceptation du vide en deux énoncés — si le retypage échoue, la contrainte n'est pas partie pour autant ;
- MySQL et SQL Server remplacent la définition : taire l'acceptation
du vide ne la conserve pas, elle la remet à
NULL. Elle est donc toujours redite ; - Oracle ne redit que ce qui change :
MODIFY (c NOT NULL)sur une colonne déjà obligatoire lèveORA-01442; - SQLite ne sait pas retyper une colonne existante — cela demande de recréer la table et d'y recopier les lignes. L'écran le dit plutôt que de proposer un bouton qui échouerait. Ajouter et supprimer y restent offerts : la restriction ne porte que sur le retypage ;
- SQL Server n'accepte pas le mot
COLUMNaprèsADD, et Oracle veut sa parenthèse et sonDEFAULTavant leNOT NULL.
Le droit et la trace sont ceux du mode écriture : connection:write_sql, et
chaque énoncé dans l'audit.
Sécurité
- Les paramètres secrets (mots de passe, clés, tokens) sont chiffrés en base et masqués dans l'interface ;
- ils ne transitent vers le runner qu'au moment de l'exécution ou d'un test ;
- les droits du projet (RBAC) contrôlent qui peut voir, éditer et tester les connexions.
Utilisez des comptes de service dédiés, avec les permissions minimales, et des identifiants différents par environnement : c'est précisément ce que le modèle valeurs-par-environnement permet.